

Devin 在 Modal GPU 上对 FLUX LoRA 进行后训练,部署效果最佳的检查点,并将其添加到聊天应用中
开始之前
- 创建 Modal outpost:运行
uvx modal-devin init,并为生成的 Modal 应用选择 GPU。参见在 Modal 上运行 Devin和 Outposts 快速开始。 - 连接您的代码仓库:示例代码仓库 otterchat 是一个带有图像模型选择器的聊天应用。outpost 会将其检出到持久化的 Modal Volume 上。
- 准备训练数据:将带说明文字的图片添加到代码仓库或 outpost 挂载的 Modal Volume 中。示例使用了 18 张卡通水獭图片,说明文字形如“Devin the software engineer in a data center”。
- 添加 secrets:将您的 Weights & Biases 密钥保存到设置 > 密钥中。Modal 沙盒已自带 Modal 凭据,因此 Devin 无需额外配置即可部署端点。
- 为长时间运行的任务设置规则:添加组织规则 (或直接写入提示中) ,例如:每 15 分钟发布一次进度更新、在每个检查点渲染验证图像,以及在每个 PR 中附上预览链接。
- 连接 Slack (可选) :训练运行实例通常需要数小时,因此建议将会话同步到 Slack 会话线程,以便随时跟进进度。
步骤 1:在 outpost 上启动会话
打开 Devin,在提示框下方的 Virtual environment 菜单中选择你的 Modal outpost,然后在消息编辑器中打开 Slack 开关。检查硬件配置:步骤 2:检查训练数据
步骤 3:开始运行训练
- 训练 LoRA:约 1,000 步,日志记录到 Weights & Biases,每 100 步渲染一次验证图像。
- 向 Slack 汇报:每 15 分钟发送一次进度和最新渲染图。早期渲染图中是人物;随着训练推进,水獭逐渐显现。
- 挑选最佳检查点:选定第 700 步,因为第 900 步和第 1,000 步已出现过拟合迹象。
- 部署并交付:将第 700 步的检查点部署为 serverless Modal 端点,将
otterimage 1.0添加到聊天应用的模型选择器中,录制一次端到端测试,并创建一个附带预览链接的 PR。
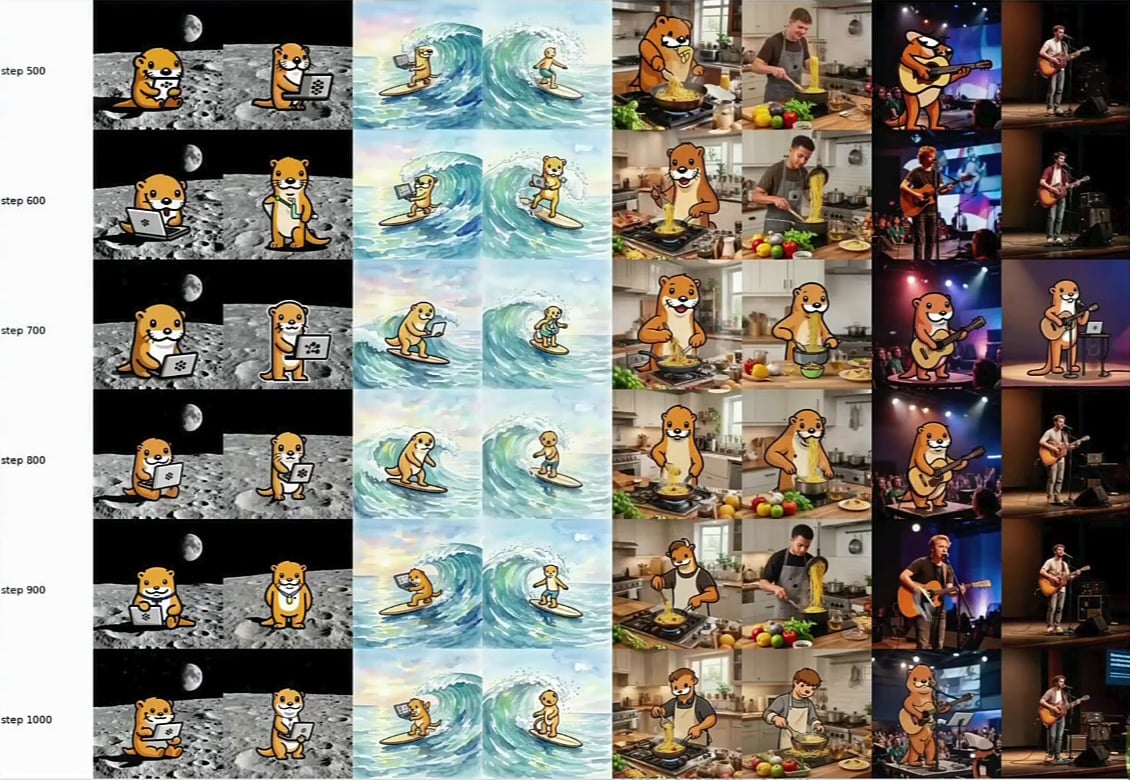
第 500 步至第 1,000 步的验证渲染图
步骤 4:试用模型
打开 PR 中的预览链接,让模型生成一张图片: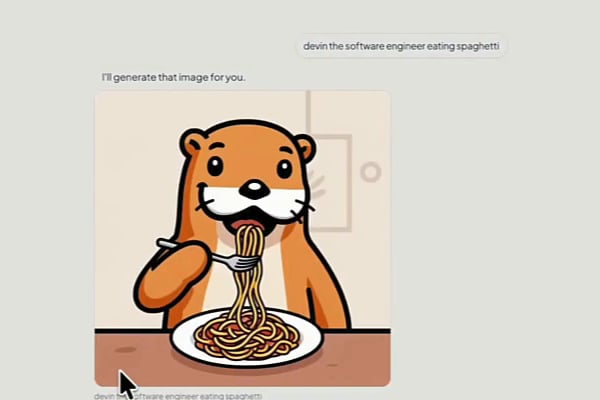
步骤 5:借助子会话迭代
后训练很少能一次运行就完成。把一篇论文交给 Devin,让它并行尝试各种替代方案: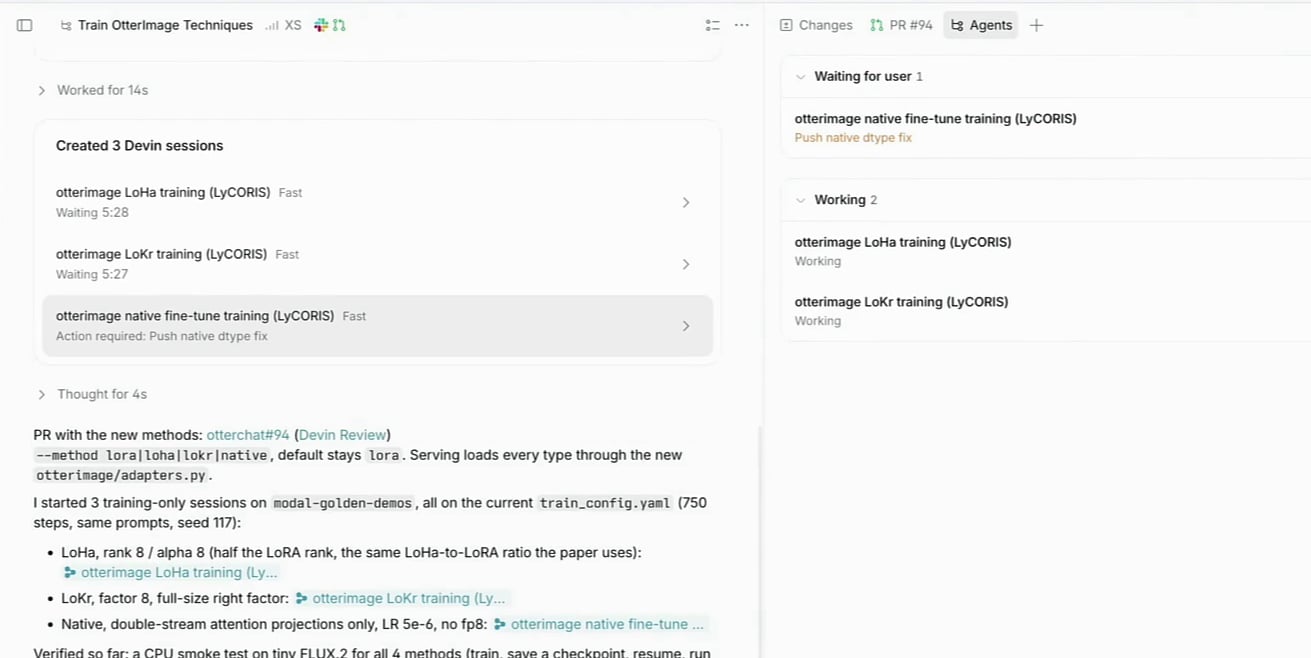
后续步骤
在 Modal 上运行 Devin
创建基于 Modal 的 outpost,并配备 GPU、Volumes 和 Secrets
Devin Outposts
在您自己的基础设施或合作伙伴平台上运行会话
Slack 集成
在 Slack 会话线程中跟进长时间运行的会话
托管 Devins
启动并监控子会话,并行开展实验