

Devin esegue il post-addestramento di una LoRA FLUX su una GPU Modal, distribuisce il checkpoint migliore e lo aggiunge a un'app di chat
Prima di iniziare
- Crea un outpost Modal: esegui
uvx modal-devin inite scegli una GPU per l’app Modal generata. Consulta Esegui Devin su Modal e la guida rapida di Outposts. - Collega il tuo repository: il repo di esempio, otterchat, è un’app di chat con un selettore del modello di immagini. L’outpost ne esegue il checkout su un Modal Volume persistente.
- Prepara i dati di addestramento: aggiungi immagini con didascalia al repository o a un Modal Volume montato dall’outpost. L’esempio usa 18 immagini di lontre in stile cartone animato con didascalie come “Devin the software engineer in a data center”.
- Aggiungi i segreti: salva la tua chiave di Weights & Biases in Impostazioni > Segreti. La sandbox Modal dispone già delle credenziali Modal, quindi Devin può distribuire gli endpoint senza configurazioni aggiuntive.
- Imposta regole per i run lunghi: aggiungi regole dell’organizzazione (o inseriscile nel prompt), ad esempio: pubblicare un aggiornamento sui progressi ogni 15 minuti, generare immagini di convalida a ogni checkpoint e includere il collegamento all’anteprima in ogni PR.
- Collega Slack (facoltativo): i run di addestramento durano ore, quindi sincronizza la sessione con un thread di Slack per seguirne l’avanzamento.
Passaggio 1: Avvia una sessione sull’outpost
Apri Devin, seleziona il tuo outpost Modal dal menu Virtual environment sotto la casella del prompt e attiva il toggle di Slack nel compositore. Verifica l’hardware:Passaggio 2: Verificare i dati di addestramento
Passaggio 3: Avvia il run di addestramento
- Addestra la LoRA: circa 1.000 step, registrati su Weights & Biases, con render di convalida ogni 100 step.
- Aggiorna su Slack: invia i progressi ogni 15 minuti insieme ai render più recenti. I primi render mostrano esseri umani; la lontra compare man mano che l’addestramento prosegue.
- Sceglie il checkpoint migliore: lo step 700, poiché gli step 900 e 1.000 mostravano segni di overfitting.
- Distribuisce e rilascia: serve lo step 700 come endpoint serverless su Modal, aggiunge
otterimage 1.0al selettore del modello dell’app di chat, registra un test end-to-end e apre una PR con un collegamento di anteprima.
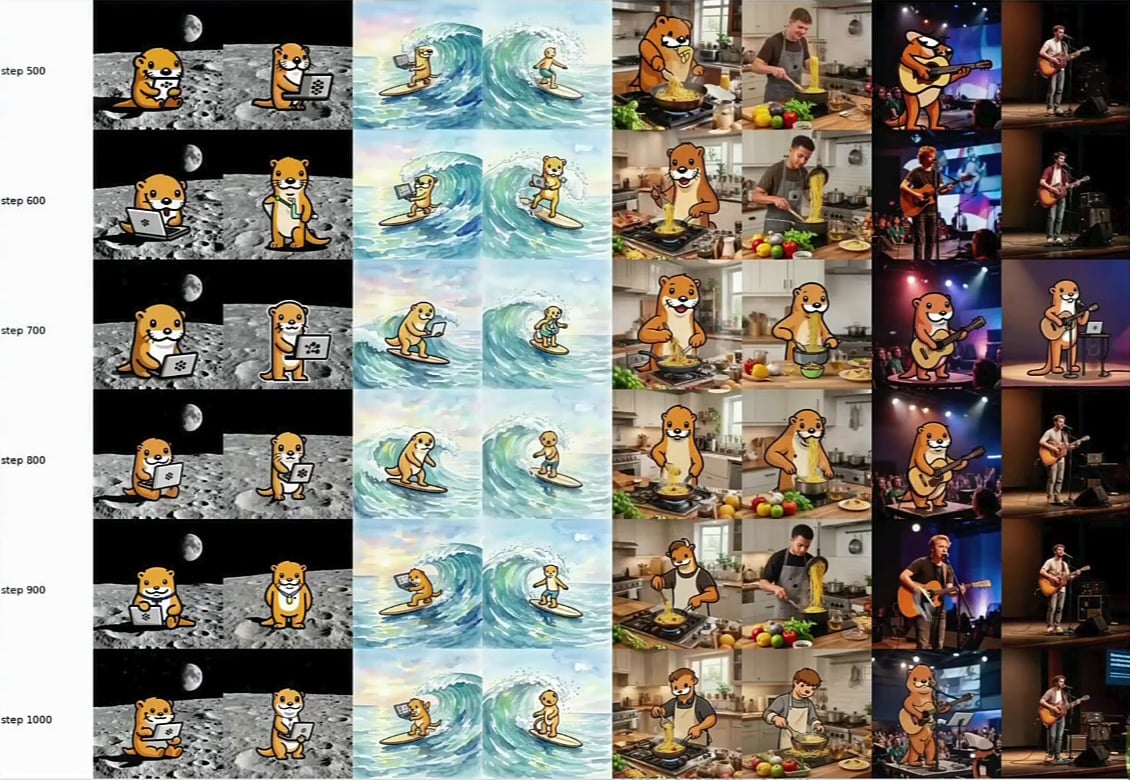
Render di convalida dallo step 500 allo step 1.000
Passaggio 4: Prova il modello
Apri il collegamento di anteprima nella PR e chiedi di generare un’immagine: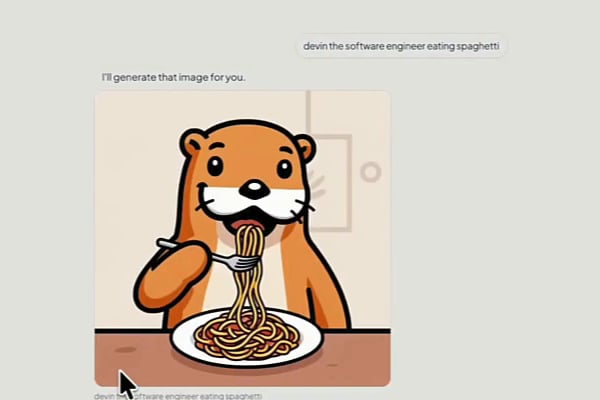
Passaggio 5: Itera con le sessioni figlie
Il post-addestramento raramente si esaurisce in un solo run. Fornisci a Devin un paper e lascia che sperimenti le alternative in parallelo: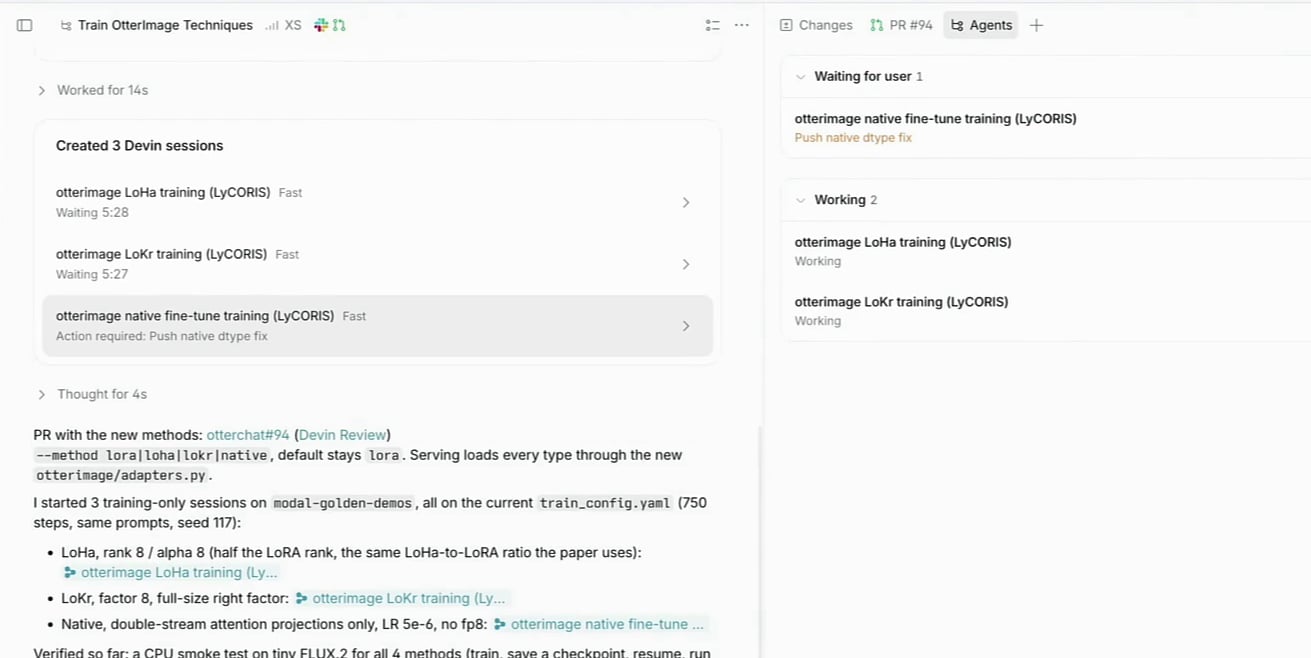
Passaggi successivi
Esegui Devin su Modal
Crea un outpost basato su Modal con GPU, Volumes e Secrets
Devin Outposts
Esegui le sessioni sulla tua infrastruttura o su una piattaforma partner
Integrazione con Slack
Segui le sessioni di lunga durata da un thread di Slack
Devin gestiti
Avvia e monitora sessioni figlie per eseguire esperimenti in parallelo